

 投稿日: 2026.10.02
 最終更新日: 2026.10.02
LLM(大規模言語モデル)とは?生成AIとの違いや仕組み・できることをわかりやすく解説


ChatGPTをはじめとする生成AIの普及により、「LLM」という言葉を目にする機会が増えています。
LLMは、自然な文章の作成や質問への回答、翻訳、要約などを可能にするAIモデルです。
しかし、「生成AIとは何が違うのか」「ChatGPTそのものをLLMと呼ぶのか」など、言葉の意味がわかりにくいと感じるケースもあるでしょう。
そこでこの記事では、LLMとは何かを初心者向けに解説し、生成AI・ChatGPT・LMMとの違いや文章を生成する仕組み、活用例、利用時の注意点まで紹介します。
目次
LLM(大規模言語モデル)とは
LLMとは「Large Language Model」の略称で、日本語では「大規模言語モデル」と呼ばれます。
まずはLLMの基本的な意味と、前提となる「言語モデル」について理解しておきましょう。
LLMの概要
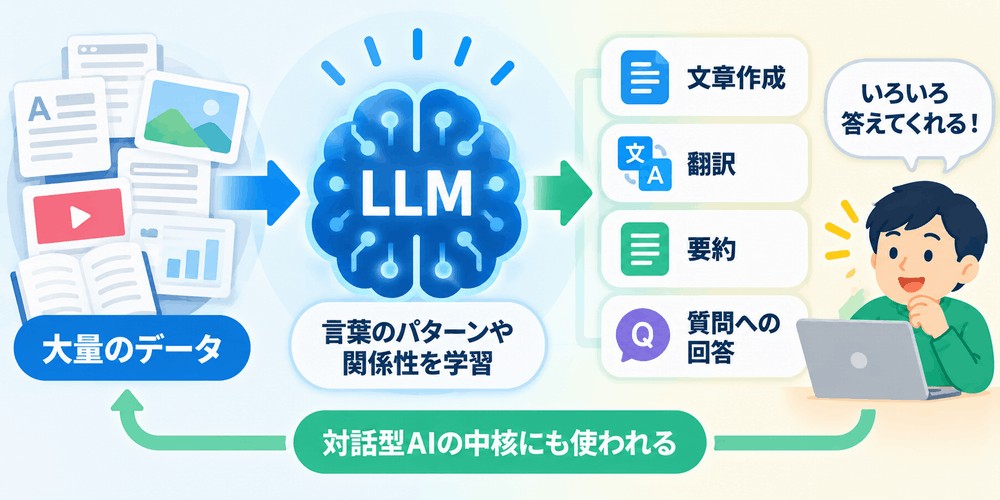
LLMは、大量のデータを使って学習し、人間が使用する言語を処理するために作られたAIモデルです。
Google Cloudでは、LLMについて次のように説明しています。
大規模言語モデル(LLM)は、膨大な量のデータでトレーニングされたテキスト主導の基盤モデルです。LLM は、テキスト生成、機械翻訳、テキスト要約、質問応答などの自然言語処理(NLP)タスクを実行するために使用されます。
引用元:生成AIの用語集 | Google Cloud
つまりLLMは、大量の文章から言葉のパターンや関係性を学習し、文章作成、翻訳、要約、質問への回答などをおこなえるモデルです。
ChatGPTなどの対話型AIでも、回答を生成する中核部分としてLLMが利用されています。
そもそも言語モデルとは
言語モデルとは、文章の流れをもとに、どのような言葉が続く可能性が高いかを確率的に扱うモデルです。
例えば、
「今日は天気がとても__」
という文章があった場合、「良い」「悪い」「不安定だ」といった言葉が続く可能性が高いです。
言語モデルは、大量の文章から言葉の並び方や関係性を学び、「文脈から考えて次にはどのような表現が続きやすいか」を計算します。
LLMも、基本的な考え方は同じです。
ただし、扱うデータやモデルの規模が非常に大きくなったことで、単純に直前の言葉だけを見るのではなく、長い文章の文脈や言葉同士の関係を踏まえながら処理できるようになっています。
なぜ「大規模」と呼ばれる?
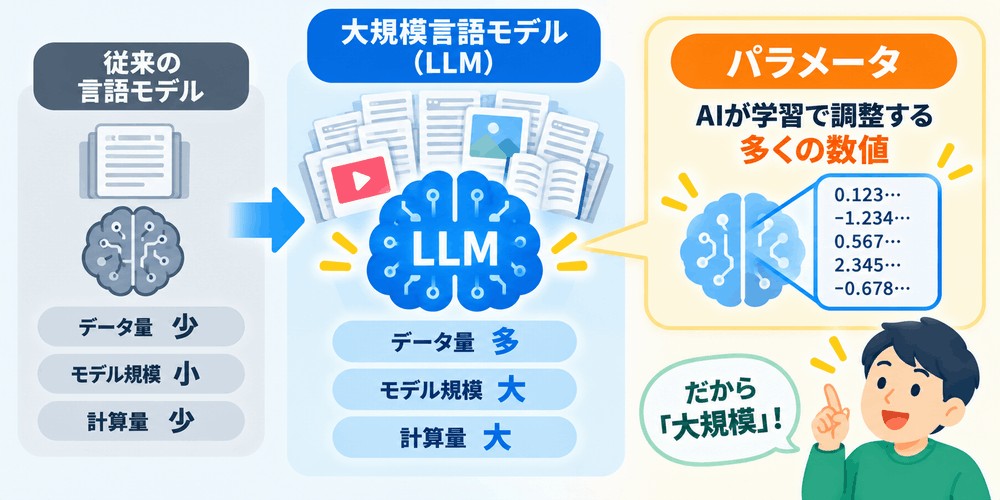
LLMが「大規模言語モデル」と呼ばれる理由は、従来の言語モデルと比べて、学習に使うデータ量やモデルの規模、学習に必要な計算量などが大幅に増えているためです。
特に重要な要素の一つが「パラメータ」です。
パラメータとは、簡単にいうと、AIが学習を通じて調整する多数の数値です。
言葉同士の関係やパターンを処理する際に利用され、学習を重ねながら適切な値へ調整されていきます。
なお、「パラメータ数が多いモデルほど必ず優秀」という単純な関係ではありません。
学習データの品質、モデルの設計、学習方法、利用目的なども性能に影響します。
LLMを理解する際は、単純な数字だけではなく、「大規模なデータと計算資源を使って高度な言語処理能力を獲得したモデル」と捉えるとよいでしょう。
LLMと生成AI・ChatGPT・LMMの違い
LLMと混同されやすい言葉として、「生成AI」「ChatGPT」「LMM」があります。
それぞれの関係を簡単に整理すると、以下のようになります。
| 用語 | 概要 |
| LLM | 言語の処理・生成を担う大規模なAIモデル |
| 生成AI | テキスト・画像・音声・動画などを生成するAI技術の総称 |
| ChatGPT | LLMなどを利用して提供されるAIサービス |
| LMM | テキストだけでなく画像・音声など複数種類の情報を扱うモデル |
それぞれ、詳しく解説していきます。
LLMと生成AIの違い
生成AIとは、文章、画像、音声、動画など、新しいコンテンツを生成できるAI技術を広く指す言葉です。
そしてLLMは、主に言語を扱う大規模なモデルです。
したがって、生成AIという大きなカテゴリーの中に、LLMを利用した文章生成などが含まれていると考えるとわかりやすいでしょう。
現在は画像や音声まで扱えるLLM系モデルも増えており、境界は以前より複雑になっています。
それでも基本的には、「生成AIは幅広い技術やサービスの総称」「LLMは言語処理を中心とするモデル」と整理すると理解しやすくなります。
LLMとChatGPTの違い
LLMとChatGPTは、そもそも比較するものではありません。
LLMは文章を処理・生成するためのAIモデルであり、ChatGPTはOpenAIが提供しているAIサービスです。
自動車に例えるなら、LLMが「エンジン」に近く、ChatGPTはエンジンを含むさまざまな機能を組み合わせた「自動車」に近い関係だと考えるとわかりやすいでしょう。
LLMを中心に、検索やファイル処理をはじめとした複数の機能を組み合わせることで、実用的なAIサービスが構築されています。
LLMとLMMの違い
LMMは「Large Multimodal Model」の略で、文章だけでなく、画像や音声など複数の種類の情報を扱えるAIモデルです。
写真を見せて内容を説明してもらったり、グラフを読み取って分析してもらったりすることができます。
LLMは主に言語を扱うモデルとして発展してきましたが、現在は画像や音声にも対応できるモデルが増えています。
そのため、実務上はLLMとLMMの境界線が以前よりも曖昧になってきている傾向が見られます。
LLMが文章を生成する仕組み
LLMの内部では非常に複雑な計算が行われていますが、基本的な流れはシンプルに整理できます。
初心者向けに、文章が入力されてから回答が作られるまでを6つのステップで見ていきましょう。
【STEP.1】トークン化(文章をAIが処理できる小さな単位に分ける)
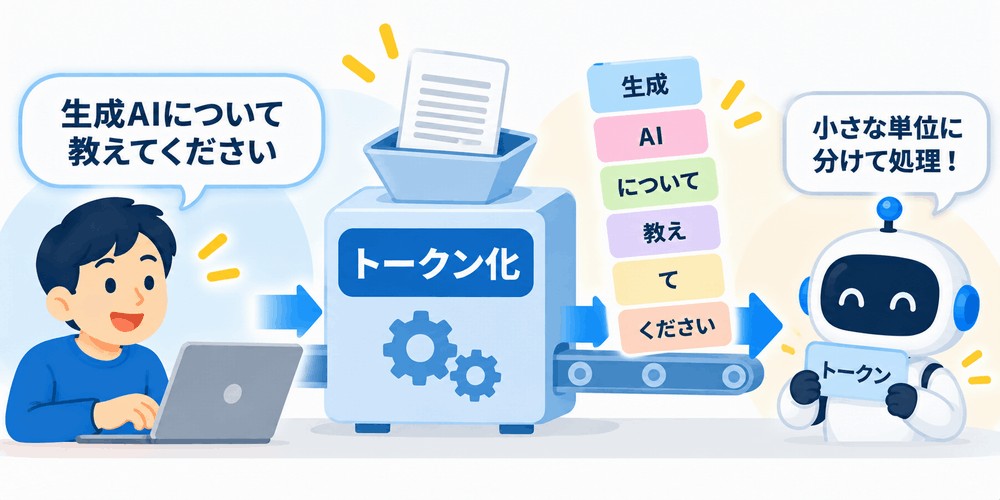
最初に、入力された文章を「トークン」と呼ばれる小さな単位へ分けます。
LLMは、人間が書いた文章をそのままの形で処理しているわけではありません。
まず文章を細かく区切り、計算しやすい状態へ変える必要があります。
トークンは必ずしも1単語とは限らず、単語の一部分や記号などが一つのトークンになる場合もあります。
例えば「生成AIについて教えてください」という文章も、モデルごとのルールに従って複数のトークンへ分割されます。
長い文章を、AIが扱いやすい小さな「部品」に分ける作業だと考えると、イメージしやすいでしょう。
つまりトークン化とは、人間の文章をLLMが処理しやすい形へ細かく分ける作業です。
【STEP.2】ベクトル化(トークンを数字の組み合わせに変換する)
次に、分割したトークンを「ベクトル」と呼ばれる数字の組み合わせへ変換します。
コンピューターは、「犬」「猫」といった言葉を、人間と同じように文字の意味として直接理解しているわけではありません。
そのため、言葉の特徴を計算できるよう数値で表現します。
例えば「犬」と「猫」はどちらも動物なので、意味的に近い関係にあります。
しかし、「犬」と「自動車」では意味が大きく異なります。
言葉を数字へ変換することで、LLMは「犬と猫は比較的近い」「犬と自動車は離れている」といった関係を計算できるようになるのです。
このように、言葉を数値として表現する仕組みは「エンベディング」とも呼ばれます。
【STEP.3】ニューラルネットワークで処理する(言葉同士の関係や文脈を読み取る)
数字へ変換した情報は、ニューラルネットワークを使って処理されます。
現在のLLMでは、「Transformer」と呼ばれる仕組みが広く利用されています。
Transformerが得意としているのは、文章の中にある言葉同士の関係を調べることです。
例えば、
「太郎はリンゴを買いました。彼は家に帰りました」
という文章では、「彼」が誰を指しているのか判断する必要があります。
LLMは、「太郎」「リンゴ」「彼」「家」などを一つずつ独立して見るのではなく、文章全体を確認しながら、どの言葉同士が強く関係しているのかを計算します。
こうした処理によって、単語を単独で扱うのではなく、文章全体を踏まえて次の処理へ進めるようになります。
【STEP.4】文脈を読み取る(前後の言葉の関係から意味を判断する)
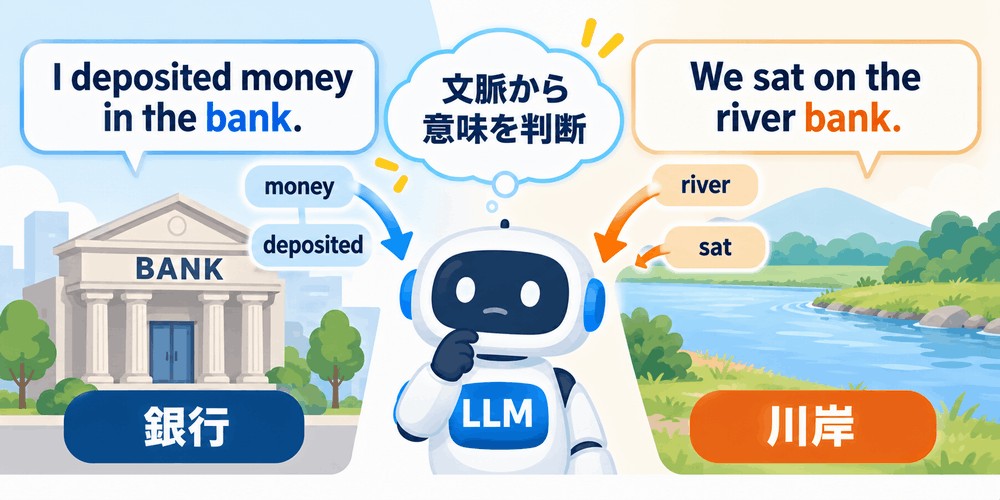
言葉同士の関係を調べながら、LLMは文章全体の文脈を読み取ります。
同じ言葉でも、前後の文章によって意味が変わる場合があるためです。
例えば英語の「bank」には、「銀行」と「川岸」という異なる意味があります。
「I deposited money in the bank.」であれば銀行を意味し、「We sat on the river bank.」であれば川岸を意味します。
LLMは、「money」や「river」といった周囲の言葉との関係を確認しながら、どの意味で使われている可能性が高いのかを判断します。
人間とまったく同じ方法で文章を理解しているわけではありませんが、大量の文章から学習した言葉のパターンを利用することで、前後の流れに合った意味を捉えられるようになっています。
【STEP.5】次に続くトークンを予測する(文脈から最も適切そうな続きを選ぶ)
文章の文脈を処理したあと、LLMは「次にどのトークンが続く可能性が高いか」を計算します。
例として、
「日本の首都は」
という文章であれば、「東京」が続く可能性は非常に高いでしょう。
LLMは、学習してきた大量の文章と、それまでの会話や文章の流れをもとに、次に続く候補それぞれの確率を計算します。
ここで重要なのは、完成した回答を最初から丸ごと用意しているわけではない点です。
LLMは現在までの文脈を見ながら、その時点で最も自然だと考えられる次のトークンを順番に選んでいます。
【STEP.6】予測を繰り返して文章を作る(1トークンずつ続きを生成する)
次のトークンを選んだら、LLMは生成した内容も新しい文脈として利用し、さらに次のトークンを予測します。
イメージとしては、
「日本の」
↓
「日本の首都は」
↓
「日本の首都は東京」
↓
「日本の首都は東京です」
というように、続きを少しずつ作っていく仕組みです。
実際には、トークンの区切り方はもっと細かくなる場合がありますが、基本的な考え方は変わりません。
長い回答であっても、最初から完成した文章を取り出しているのではなく、「次に何が続く可能性が高いか」という予測を何度も繰り返して生成しています。
LLMが自然な文章を作れるのは、大量の文章から学習した言葉のパターンと文脈をもとに、適切な続きを高い精度で予測できるためです。
LLMは「答えを知っている」わけではない
LLMは高度な質問にも自然な文章で回答できますが、人間のように事実をすべて理解し、正しい答えを保持しているわけではありません。
LLMを安全に活用するためにも、回答が作られる仕組みと限界を、さらに詳しく理解しておきましょう。
LLMは確率にもとづいて文章を生成する
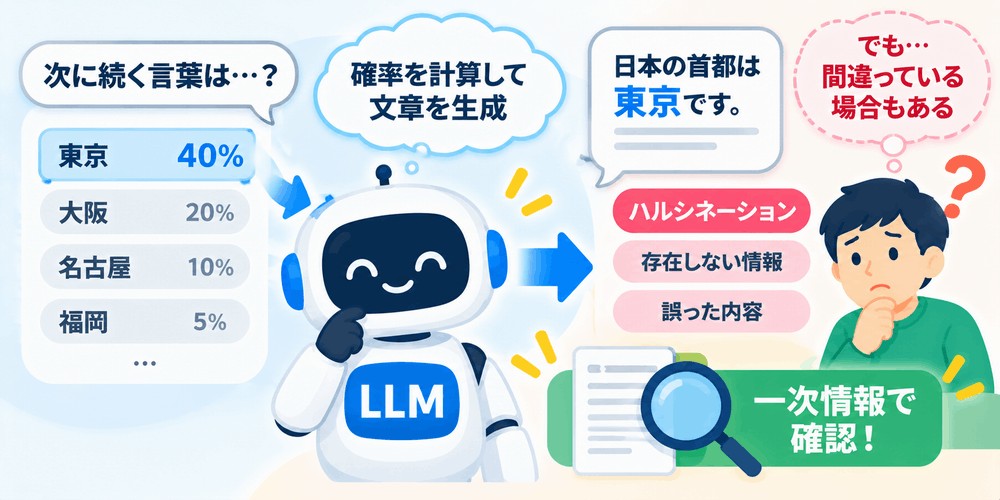
LLMは、一般的なデータベースのように「質問に対応する正解」を検索して取り出しているわけではありません。
「LLMが文章を生成する仕組み」の項目で解説した通り、入力された文脈と生成済みの文章をもとに、次に続くトークンの確率を計算しながら回答を作ります。
そのため、文章として非常に自然で説得力があっても、内容まで正しいとは限りません。
事実とは異なる情報や、実際には存在しない人物・書籍・URLなどを、もっともらしく生成する場合があります。
この現象は、一般的に「ハルシネーション」と呼ばれます。
したがって、重要な判断にAIを利用する場合は、「自然な文章だから正しい」と考えず、一次情報や信頼できる資料と照合してください。
最新情報を常に知っているわけではない
LLMがもつ知識は、基本的に学習に使用されたデータなどに依存します。
モデルの学習後に発生したニュース、新しく発売された商品、制度改正、最新の価格などを、LLM単体が自動的に知っているわけではありません。
また、学習時点以前の出来事であっても、すべての情報を正確に保持しているとは限りません。
とはいえ、現在のAIサービスでは、LLMにWeb検索などの外部機能を組み合わせ、最新情報を取得してから回答できるケースが増えています。
ChatGPTでは、Web検索を利用して現在の情報を取得し、回答に情報源を付ける機能が提供されています。
最新情報が重要な質問では、情報源まで確認しましょう。
RAGで外部情報を補える
LLMがもっていない情報を補う代表的な方法の一つが、「RAG(Retrieval-Augmented Generation/検索拡張生成)」です。
RAGでは、LLMが回答を作る前に、外部の資料やデータベースから必要な情報を探します。
そして、見つけた情報を参考にしながら回答を生成します。
例えば、社内マニュアルをRAGの検索対象にしておけば、「有給休暇の申請方法を教えて」と質問された際に、社内ルールを確認したうえで回答させることが可能です。
つまりRAGは、LLMがもともと持っていない情報を、回答するタイミングで補う仕組みだといえます。
LLMでできること・主な活用例
LLMは文章生成だけでなく、要約、翻訳、情報整理、プログラミングなど幅広い業務に活用できます。
ここでは、代表的な活用例を紹介します。
文章作成・校正
LLMの代表的な活用方法が、文章の作成や校正です。
メール、企画書、Web記事、商品説明文、SNS投稿などの下書きを作らせれば、文章作成にかかる時間を短縮できます。
すでに書いた文章を入力して、「誤字脱字を確認してほしい」「もう少しわかりやすく書き換えてほしい」と指示する使い方も可能です。
また、同じ内容を「取引先向けに丁寧に」「初心者にもわかるように」といった形で、対象読者に合わせて調整できます。
ただし、LLMが生成した文章をそのまま公開するのはおすすめできません。
ハルシネーションの問題があるので、LLMはあくまで「下書きや編集を効率化する補助ツール」として使うべきです。
要約・分類・情報抽出
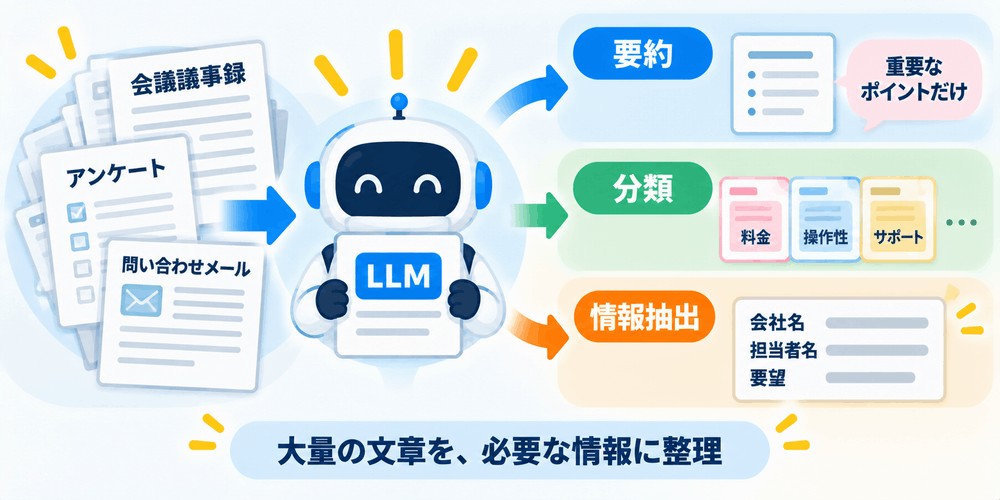
LLMは、大量の文章から必要な情報を整理する用途にも活用できます。
例えば、長い会議の議事録を入力し、「決定事項と今後の対応だけをまとめてください」と指示すれば、重要な部分を抽出して短く整理できます。
顧客アンケートを「料金」「操作性」「サポート」などのテーマに分類したり、問い合わせメールから会社名・担当者名・要望だけを抽出したりする使い方も便利でしょう。
大量の文章を一件ずつ人間が読む作業を減らせるため、バックオフィスやマーケティング、カスタマーサポートなど幅広い業務で役立ちます。
翻訳・質問応答
LLMは、多くの言語パターンを学習しているため、翻訳や質問応答にも利用できます。
単純に文章を別の言語へ変換するだけでなく、「ビジネスメールとして自然な英語にする」「専門用語を残したまま翻訳する」といった条件を指定できる点も便利です。
質問応答では、一般的な知識について質問したり、入力した資料について内容を尋ねたりできます。
このように、作業を効率化できる一方、もちろんハルシネーションの問題は残ります。
プログラミング支援
LLMは自然言語だけでなく、プログラミングコードの生成や説明にも活用されています。
「PythonでCSVファイルを読み込み、特定の列だけ抽出するコードを書いてください」
このように指示すれば、目的に応じたコード案を簡単に作成できます。
その他にも、既存コードを入力してエラーの原因を調べたり、「初心者向けに1行ずつ説明してください」と依頼したりする使い方も便利です。
LLMは、精度の高いコードを出力する一方で、必ずしも正しく安全とは限りません。
存在しないライブラリや関数を提示したり、セキュリティ上の問題を含んだりする場合があります。
そのため、出力されたコードに対しては、エンジニアによる十分な検証が必要です。
カスタマーサポート
LLMは、顧客からの問い合わせ対応を効率化する用途にも活用できます。
従来型のチャットボットでは、事前に設定した質問と回答の組み合わせから返答する仕組みが中心でした。
しかしLLMを活用すれば、ユーザーが自由な文章で質問しても内容を整理し、より自然な形で回答を作成できます。
こうした仕組みを導入する際は、料金や契約条件などを誤って案内しないよう、回答できる範囲をあらかじめ決めておくことが重要です。
複雑な問い合わせは有人対応へ切り替えるなど、LLMと人間の役割を分けて運用するとよいでしょう。
LLMを利用する際の課題・注意点
LLMは、業務を大きく効率化できる一方、万能な技術ではありません。
企業で利用する場合は、情報の正確性だけでなく、セキュリティや権利関係にも注意しましょう。
誤った情報を生成することがある
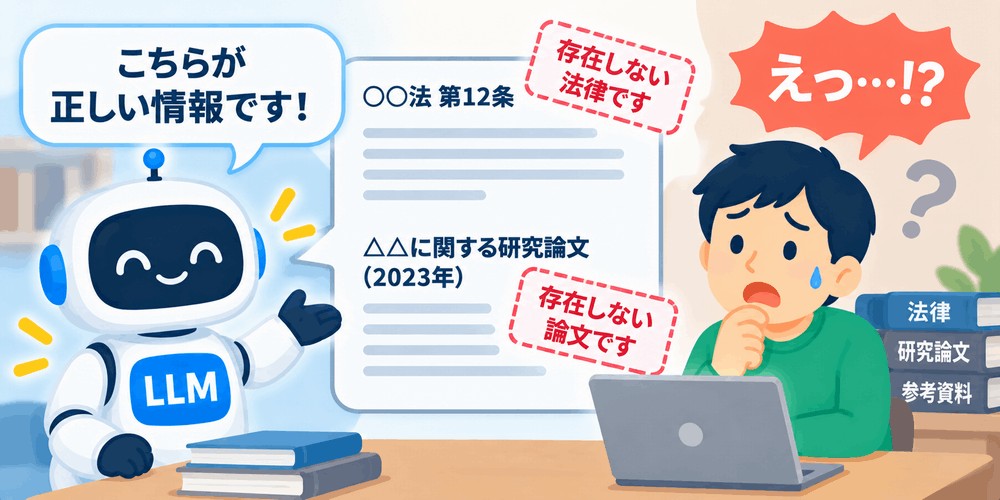
LLMを利用するうえで特に注意したいのが、ハルシネーションです。
LLMは、文脈に合った文章を生成する能力が高いため、誤った内容でも非常に自然な文章で提示する場合があります。
実在しない法律の条文を紹介したり、存在しない研究論文を出典として示したり、といった形です。
文章が具体的で自信をもっているように見えても、正確性が保証されるわけではないので注意してください。
個人情報・機密情報の入力に注意する
LLMを利用した生成AIサービスで、以下のような情報を安易に入力するのは避けましょう。
- メールアドレス
- 未公開の商品情報
- 契約書
- 売上データ
- パスワード
入力したデータをAIモデルの学習に利用するかどうかは、サービスやプラン、設定によって異なります。
例えば、ChatGPT Business・Enterprise・APIでは、入力・出力はデフォルトでモデルの学習に利用されません。
しかし、個人向けChatGPTでは、設定によって会話内容がモデル改善に利用される場合があります。
なお、学習に利用されないサービスであっても、データが一切保存・処理されないとは限りません。
企業でLLMを利用する場合は、利用しているサービスの規約やデータ管理方針を確認し、「入力してよい情報」「入力してはいけない情報」を社内で明確にしておきましょう。
学習データの偏りが回答に影響することがある
LLMは大量のデータから言葉のパターンを学習するため、学習データに含まれる偏りが回答へ反映される可能性があります。
特定の地域や文化、職業、性別などに関する情報へ偏りがある場合、社会に存在する固定観念を含んだ回答が生成されることもあります。
したがって、LLMの回答を「客観的な判断」と考えるのは適切ではありません。
特に採用、人事評価、融資、教育など、人に大きな影響を与える用途では、AIの回答だけで判断を完結させず、複数の情報を確認したうえで人間が最終判断をするようにしてください。
著作権・利用規約を確認する
LLMを使ってコンテンツを作成する場合は、著作権や利用しているAIサービスの規約も確認しましょう。
第三者が作成した文章を大量に入力し、「ほぼ同じ文章を書いて」と依頼すると、生成結果の利用方法によっては著作権上の問題が生じる可能性があります。
企業名やキャラクター、画像などを扱う場合には、著作権以外の権利にも注意が必要です。
また、AIサービスによって商用利用の条件や、入力・出力データの扱いは異なります。
「AIが生成したから自由に使える」と一律に考えるべきではありません。
LLMに関するよくある質問
最後に、LLMに関するよくある疑問について簡潔に整理します。
LLMとは簡単にいうと何?
LLMとは、大量の文章などを学習し、入力された内容に応じて文章を生成できる大規模なAIモデルです。
日本語では「大規模言語モデル」と呼ばれ、文脈から次に続く言葉を予測し、その処理を繰り返して文章を作ります。
文章作成だけでなく、要約、翻訳、質問応答、プログラミング支援など幅広い用途に活用されています。
LLMとAIの違いは?
AIは、人間の知的な活動に関連する処理をコンピューターで実現する技術全般を指します。
LLMは、AIという大きなカテゴリーに含まれる技術の一つです。
特に文章などの言語処理を得意とし、大量のデータを学習して文章生成や要約、翻訳などを行います。
つまり、「AI=LLM」ではなく、「AIの一種がLLM」と理解するとわかりやすいでしょう。
LLMとChatGPTの違いは?
LLMは文章を生成するための「AIモデル」、ChatGPTはLLMなどを利用して提供される「AIサービス」です。
イメージとしては、LLMがエンジン、ChatGPTがエンジンを搭載した自動車、といった形です。
LLMとLLMOの違いは?
LLMは「Large Language Model」の略で、文章の生成や処理を行う大規模言語モデルです。
LLMOは「Large Language Model Optimization」の略で、ChatGPTやGeminiなどのAIサービスに、自社やブランドの情報を適切に理解・言及してもらいやすくするための最適化を指します。
つまり、LLMはAI技術、LLMOはAI環境への最適化施策という違いがあります。
LLMO対策でお悩みの場合は株式会社NOBUがおすすめ
生成AIによる情報収集が広がる中、Webサイトでは従来のSEOだけでなく、AIから自社情報を正確に理解・参照してもらう視点も重要になっています。
LLMOを意識したコンテンツ制作やWebサイト改善に不安がある場合は、SEOやWebマーケティングの豊富なノウハウをもつ株式会社NOBUへご相談ください。
株式会社NOBUでは、競合分析やキーワード設計、コンテンツの見直し、Webサイト構造の改善など、企業ごとの課題に合わせたSEO対策やLLMO対策を提供しています。
検索順位だけでなく、問い合わせ獲得まで見据えた支援をおこなっている点も特徴です。
SEOを土台としながら、生成AIによる検索・情報収集も見据えたWebサイトへ改善したい場合は、お気軽にお問い合わせください。
まとめ
LLMとは、大量のデータから言葉のパターンや関係性を学習し、文章生成、要約、翻訳、質問応答などを行える大規模言語モデルです。
ChatGPTなどの生成AIサービスを支える重要な技術ですが、これまで解説してきた通り、LLMそのものと生成AIやChatGPTは同じ意味ではありません。
LLMの仕組みや特徴を正しく理解することで、生成AIをより安全かつ効果的に活用しやすくなるでしょう。
LLMOを含め、生成AI時代を見据えたSEOやWebサイト改善に課題を感じている場合は、株式会社NOBUへの相談もぜひご検討ください。


SEO対策の関連記事
2026.10.02 2026.10.02
 2026.08.25
 2026.08.25
 2026.08.25
 2026.08.25
 2026.07.19
 2026.07.19
 2026.07.19
 2026.07.19